#
Large-Language-Modelle (LLMs)
Im aiWorkplace stehen verschiedene Large-Language-Modelle (LLMs) zur Verfügung, die für Chat, Text-, Code- und Grafikgenerierung uvm. genutzt werden.
Wir empfehlen, die Kauz-Selection als Standard-Modell zu verwenden. Sie wählt für jede Aufgabe automatisch ein geeignetes und zugleich kosteneffizientes Modell aus. So profitieren Nutzende von hoher Ergebnisqualität, ohne selbst Details zu Modellklassen, Kostenstrukturen oder einzelnen Anbietern kennen zu müssen. Weitere Hintergründe finden Sie unter Kauz-Selection . Eine vollständige Liste aller Modelle mit Kontextfenster und Trainingsstand finden Sie im Modellkatalog .
#
Voraussetzungen und Einrichtung
Damit LLMs genutzt werden können, müssen sie im Administrationsbereich von den Organisations-Inhaber*innen bereitgestellt und freigeschaltet werden. Navigieren Sie dazu über Ihr Profil oben rechts zu Einstellungen > Modelle und aktivieren Sie die gewünschten Modelle.
Es empfiehlt sich, nicht alle verfügbaren Modelle freizuschalten, sondern eine überschaubare Auswahl bereitzustellen. So behalten Nutzer*innen den Überblick und es ist einfacher, Kosten, Qualität und Einsatzzwecke zu steuern.
#
Modellauswahl
Im aiWorkplace können im Chat Modelle unterschiedlicher Anbieter genutzt werden, zum Beispiel:
- kommerzielle Modelle von OpenAI, Anthropic, Google, Mistral
- Open-Source-Modelle wie Kolibri von Aleph Alpha, DeepSeek, Qwen, Kimi, GLM oder MiniMax
- die Kauz-Selection als automatische, aufgabenbezogene Modellauswahl
Bis auf die Ausnahmen unter

Modelle unterscheiden sich vor allem in Kosten, Leistung und Geschwindigkeit: Leichtgewichtige, kostengünstige Modelle eignen sich für einfache Routineaufgaben wie kurze Zusammenfassungen oder Umformulierungen, während leistungsstärkere und oft teurere Modelle bessere Ergebnisse bei komplexen, geschäftskritischen Aufgaben wie tiefgehenden Analysen, Coding oder anspruchsvoller Planung liefern.
#
Kauz-Selection: automatisch das passende Modell
Die Kauz-Selection ist die empfohlene Standardauswahl für die meisten Organisationen im aiWorkplace. Sie nimmt Nutzer*innen die Entscheidung ab, welches LLM für eine konkrete Aufgabe am besten geeignet ist: Für einfache Wissensfragen, Zusammenfassungen oder Entwürfe können effiziente Modelle genutzt werden, während für komplexe Analysen, anspruchsvolle Textarbeit oder Coding gezielt leistungsstärkere Modelle eingesetzt werden.
Im Chat steht sie als ein Eintrag in der Modellauswahl. In Cowork gibt es sie in zwei Stufen: Kauz Basic achtet vor allem auf die Kosten, Kauz Premium vor allem auf die Qualität.
So entsteht ein gutes Verhältnis aus Qualität, Geschwindigkeit und Kosten. Organisationen können ihre KI-Kosten besser steuern, ohne dass Mitarbeitende Modellklassen, Anbieter oder Kostenstrukturen im Detail kennen müssen. Mehr Details und Beispiele zur Kauz-Selection finden Sie hier: Kauz-Selection .
#
Empfohlene Modellauswahl
Für die meisten Organisationen ist die einfachste Empfehlung:
- Kauz-Selection aktivieren
- Kauz-Selection als Standard-Modell setzen
- optional einzelne Spezialmodelle zusätzlich freischalten, wenn bestimmte Teams diese gezielt benötigen
So entsteht ein gutes Verhältnis aus Qualität, Geschwindigkeit und Kosten, ohne dass alle Nutzenden selbst Modellnamen, Anbieter und Kostenprofile vergleichen müssen.
#
Empfohlene Modellauswahl (kommerzielle Anbieter)
Die Modellauswahl bietet eine Mischung aus unterschiedlichen Kosten und Qualitäten von unterschiedlichen Anbietern. Wenn Sie bestimmte Anbieter präferieren, können Sie die Auswahl weiter reduzieren.
Die Tabelle zeigt unsere aktuelle Empfehlung, nicht den vollständigen Modellkatalog. Ältere Versionen bleiben
verfügbar, solange sie in Ihrer Organisation freigeschaltet sind. Prüfen Sie unter Einstellungen > Modelle von Zeit
zu Zeit, welche davon Sie in der Standardauswahl behalten möchten.
#
Entfallene Modelle
Stellt ein Anbieter ein Modell ein, entfernen wir es aus dem aiWorkplace. Im Oktober 2026 betraf das Claude Sonnet 3.7, Claude Sonnet 4 und fünf ältere Chat- und Codex-Modelle von OpenAI aus den Reihen GPT-5.1 bis GPT-5.3; GPT-6 Astra ist ebenfalls abgeschaltet. Chats, Custom Agents und Voreinstellungen, die ein entfallenes Modell nutzten, wechseln automatisch zu seinem Nachfolger, wenn Ihre Organisation diesen bereits freigeschaltet hat, sonst zum Standardmodell Ihrer Organisation. Prüfen Sie danach, ob Ihre Custom Agents und Workflows weiterhin das gewünschte Modell nutzen.
#
Modelle mit eingeschränktem Datenstandort
Fable 5 ist zwar in Europa gehostet, die Daten werden gemäß Anbietervorgaben jedoch bis zu 30 Tage gespeichert und können auf Anforderung in die USA übermittelt werden. Das Modell ist im aiWorkplace deshalb deutlich mit dem Datenstandort „USA“ gekennzeichnet und in der Empfehlung oben bewusst nicht enthalten.
Setzen Sie Fable 5 gezielt ein, wenn seine Fähigkeiten für eine Aufgabe einen klaren Mehrwert bieten und Ihre Datenschutzvorgaben eine Verarbeitung unter diesen Bedingungen zulassen. Für strikte Anforderungen an Datenstandort und Datenverarbeitung empfehlen wir ein EU-gehostetes Modell, innerhalb der Anthropic-Familie etwa Claude Opus 5.5 oder Claude Sonnet 5.5, die nicht unter diese Retention Policy fallen.
#
Modellauswahl: Open Source-Alternativen
Alternativ zu kommerziellen Modellen stehen auch Open Source Modelle zur Verfügung. Diese sind zwar weniger bekannt, aber kostengünstig und erreichen bei den meisten Aufgaben 90-98% der Performance von kommerziellen Modellen. Sie haben außerdem den Vorteil, dass sie auch im eigenen Rechenzentrum (on premise) betrieben werden können.
Empfehlung: Nutzende halten sich bei der Adoption weniger bekannter Modelle häufig eher zurück. Starten Sie mit der Kauz-Selection als Standard und testen Sie parallel einzelne Open Source Modelle für unkritische Aufgaben oder spezifische Teams.
(R) = Denken aktiv
In den Modelldetails der Modellauswahl und unter Einstellungen > Modelle tragen Claude Fable 5 und Kimi K3
den Hinweis, dass sie pro Nachricht deutlich mehr KI-Punkte verbrauchen als andere Modelle. Setzen Sie diese Modelle
gezielt für Aufgaben ein, die ihre Stärken wirklich brauchen.
#
Denkaufwand
Für einige Modelle steht im aiWorkplace der Denkaufwand zur Verfügung (auch als Intelligenzlevel oder Reasoning Effort bezeichnet, etwa bei GPT-5.6 Sol): zusätzliche Reasoning-Schritte, die das Modell vor der Antwort ausführt.
Sie stellen ihn über die Modellauswahl ein. Sie finden sie rechts in der Eingabeleiste neben dem Mikrofon-Symbol; auf dem Smartphone steht dort nur das Logo des ausgewählten Modells. Ein Klick öffnet die Liste der freigegebenen Modelle, am unteren Rand erscheint der Regler Denkaufwand für das ausgewählte Modell. Wählen Sie ein steuerbares Modell, bleibt die Liste geöffnet, sodass Sie die Stufe gleich mitgeben können. Ein Pfeil-Symbol setzt die Stufe auf die Voreinstellung des Anbieters zurück. Die gewählte Stufe steht anschließend neben dem Modellnamen in der Eingabeleiste.
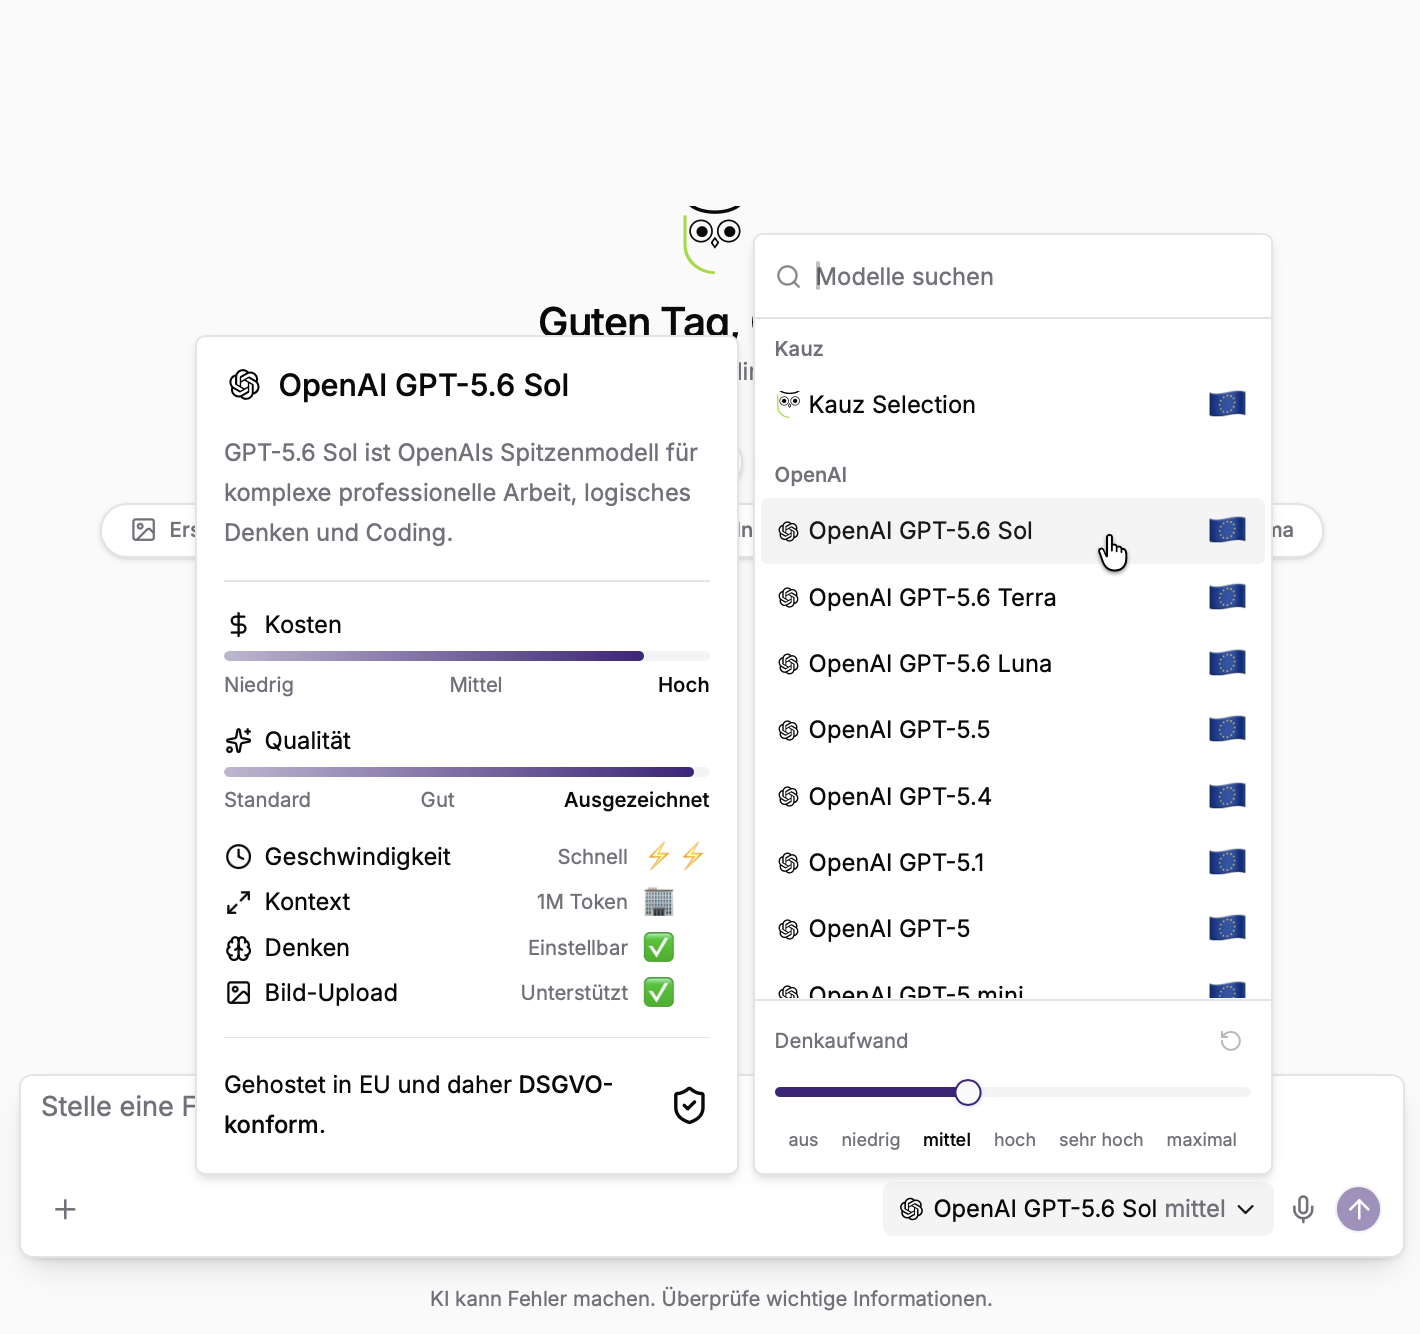
Welche Stufen ein Modell anbietet, legt der Anbieter fest. Sie stammen aus der Reihe minimal, niedrig, mittel,
hoch, sehr hoch und maximal; lässt sich das Denken ganz abschalten, steht links davon zusätzlich aus.
GPT-5.6 Sol reicht zum Beispiel von aus bis maximal, Gemini 3.1 Pro von niedrig bis hoch. Ob ein Modell den
Denkaufwand überhaupt annimmt, steht in seinen Modelldetails unter Denken.
Ein höherer Denkaufwand liefert bei komplexen, mehrstufigen Fragestellungen oft strukturiertere, besser begründete Antworten, dauert aber etwas länger und kostet in der Regel mehr. Für kurze, einfache Anfragen reicht meist eine niedrige Stufe.
Nicht jedes Modell lässt sich steuern. Viele Open-Source-Modelle, etwa von Moonshot AI (Kimi), DeepSeek, Z.ai (GLM)
und MiniMax, denken grundsätzlich mit. Der Anbieter bietet dafür keine Kontrolle, deshalb zeigt der aiWorkplace bei
diesen Modellen keinen Regler an. Bei neueren Claude-Modellen (Opus 4.6 bis Opus 5.5, Sonnet 4.6, Sonnet 5,
Sonnet 5.5, Haiku 5.5, Fable 5) und bei GPT-6.1 Sol erscheint der Regler zwar, lässt sich aber nicht auf aus stellen: Die
niedrigste Stufe ist hier bereits aktives Denken. GPT-6.1 Sol reicht von niedrig bis maximal und steht
voreingestellt auf mittel, Claude Sonnet 5.5 ebenfalls von niedrig bis maximal mit der Voreinstellung hoch. Claude Haiku 5.5
reicht von niedrig bis maximal und steht voreingestellt auf mittel.
Mistral Large 4 und Mistral Medium 3.5 kennen nur aus und hoch, voreingestellt ist hoch.
Gemini 4 Argon reicht von niedrig bis hoch und steht voreingestellt auf mittel, abschalten lässt sich das
Denken nicht. Kolibri 1 bietet aus, niedrig, mittel und hoch, voreingestellt ist mittel.
Bei der Kauz-Selection wählen Sie zwischen aus, niedrig, mittel und hoch, voreingestellt
ist aus. Die Kauz-Selection überträgt die Stufe auf das Modell, das sie für die Anfrage auswählt. Lässt sich dessen
Denken nicht abschalten, nutzt sie bei aus dessen niedrigste Stufe. In den Modelldetails steht bei Denken
Automatisch, weil das Modell erst mit der Anfrage feststeht. Bei selbst
gehosteten Modellen legen die Inhaber*innen der Organisation fest, wie das Modell denkt, siehe
Selbst gehostete Modelle
.
Der entscheidende Kostentreiber beim Denkaufwand sind die Output-Tokens. Insbesondere bei Claude Opus und Claude Sonnet ist der KI-Punkte-Verbrauch bei höheren Stufen daher sehr hoch und sollte sparsam eingesetzt werden.